Una nube de puntos alargada puede resultar bastante aburrida si la miramos desde el ángulo equivocado. Vemos dos columnas, dos ejes y un conjunto de observaciones. Giramos el papel y, de pronto, aparece algo sencillo: casi toda la variación ocurre en una dirección.
Esa imagen me parece una entrada más útil a PCA que empezar con una matriz de covarianzas. La matriz llegará, porque importa. Pero primero conviene ver qué problema estamos resolviendo: encontrar coordenadas que describan de forma compacta cómo varían los datos.
No estamos eligiendo la columna ganadora. Un componente combina columnas. Tampoco buscamos, de entrada, qué variable explica una decisión de negocio. PCA no consulta una variable objetivo para decidir sus direcciones.
Girar el papel
Imagina dos sensores que miden casi el mismo fenómeno. Sus lecturas suben y bajan juntas, con algo de ruido. En lugar de conservar dos descripciones muy parecidas, podemos buscar una dirección que recoja su variación compartida y otra que recoja la diferencia restante.
La primera componente principal es la dirección de máxima varianza de los datos centrados. La segunda es perpendicular a la primera y recoge la mayor varianza posible entre las direcciones restantes. Con más variables seguimos la misma lógica.
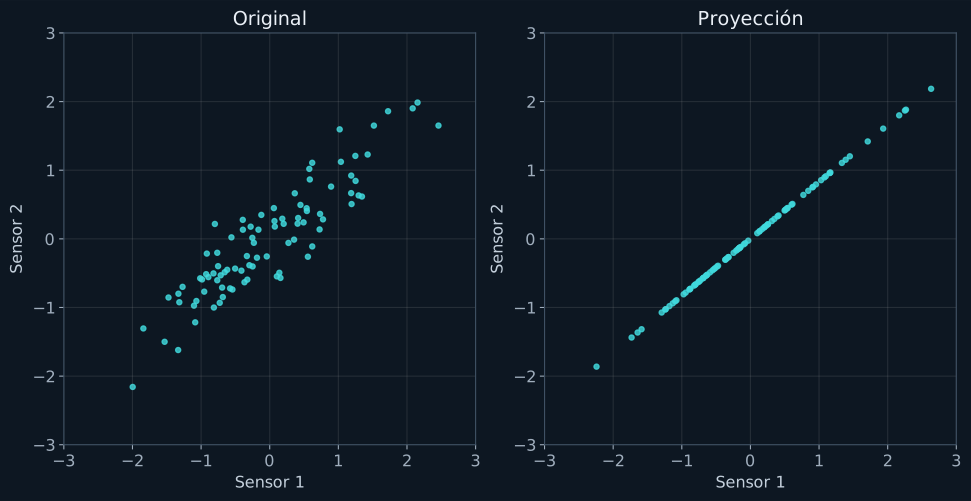
Si conservamos todas las componentes, solo hemos cambiado de coordenadas. Si nos quedamos con una, cada punto pasa a tener una única coordenada sobre esa dirección. Al reconstruirlo, vuelve a una línea. La distancia entre el punto original y su reconstrucción muestra lo que perdimos.
La proyección no es una fotografía neutral. Dos observaciones que se distinguían sobre la dirección descartada pueden terminar muy cerca. Por eso un gráfico de dos componentes puede aclarar una estructura y esconder otra al mismo tiempo. No hace falta desconfiar de todos los gráficos; hace falta recordar qué no pueden mostrar.
El tamaño del eje también cuenta una historia
Ahora cambia la unidad de un sensor: uno informa en metros y el otro en milímetros. El fenómeno es el mismo, pero la varianza numérica de uno crece mucho. PCA sobre esos valores puede orientar la primera componente hacia la variable que parece enorme por su unidad.
Centrar resta la media; estandarizar también divide por la desviación típica. Son operaciones distintas. La implementación de PCA de scikit-learn centra las variables, pero no las escala automáticamente.
Estandarizar suele ser útil cuando queremos que distintas unidades tengan una participación comparable. No es una obligación universal. Si las variables ya comparten una unidad y sus diferencias de variabilidad son relevantes, igualarlas también puede borrar parte del significado que queremos conservar.
La elección no debería desaparecer dentro de una función auxiliar. Es una decisión del análisis. Si cambiamos el preprocesamiento, cambiamos la geometría que PCA va a considerar importante. Y si hay variables constantes, mediciones poco fiables o outliers, esa revisión debe ocurrir antes de interpretar las componentes.
El porcentaje que no responde a todas las preguntas
La varianza explicada mide qué fracción de la variación total recoge cada componente, bajo el preprocesamiento utilizado. Si dos componentes acumulan el 95 %, hemos conservado gran parte de esa variación. No hemos demostrado conservar el 95 % de la utilidad predictiva, de la información causal ni del significado del problema.
Una señal de poca varianza puede distinguir un defecto raro. Un patrón de mucha varianza puede ser simplemente la temperatura ambiental. PCA optimiza su propio criterio, no una definición universal de importancia.
Para interpretar una componente miraría sus coeficientes, conocidos como cargas, y volvería a las variables originales. Un nombre como «nivel de actividad» puede ayudar si la combinación lo respalda, pero no emerge mágicamente del algoritmo. Además, el signo de una dirección puede invertirse: multiplicar una componente por menos uno no cambia el espacio que describe.
Con dos componentes podemos hacer un mapa. Para decidir cuántas conservar, miraría también la varianza acumulada, los residuos de reconstrucción y el uso posterior. Si habrá un modelo predictivo, compararía su rendimiento sin reducción y con distintas alternativas, aprendiendo escalado y PCA solo con entrenamiento.
Una matriz que resume relaciones
La covarianza recoge cómo varían juntas las columnas centradas. Sus vectores propios proporcionan las direcciones de PCA y sus valores propios indican la varianza en cada dirección. Las nuevas coordenadas quedan incorrelacionadas; eso no equivale, en general, a independencia estadística.
No necesitas calcular todos esos elementos a mano para usar PCA. Sí ayuda entender por qué la técnica responde a relaciones lineales, por qué importa la escala y por qué reducir dimensiones puede alterar lo que observamos.
En la aplicación de análisis multivariante puedes cambiar variables y mirar cómo cambia la representación. Esa comparación dice más que aprender un único gráfico bonito.
La segunda parte conecta esta geometría con SVD. Vamos a pasar de una nube de puntos a una imagen y ver qué significa reconstruir algo con menos piezas, sin fingir que una compresión matemática es lo mismo que guardar un JPEG más pequeño.
¿Te ha resultado útil? Si te apetece apoyar este espacio, puedes invitarme a un café.
Invítame a un café Apoyo voluntario a través de PayPal. Tú eliges el importe.