Mira una imagen en escala de grises muy de cerca. Detrás del dibujo hay una tabla de intensidades: una fila y una columna para cada posición del píxel. Cambiar de una fotografía a una matriz no vuelve menos interesante la imagen. Permite hacerle otra clase de preguntas.
Por ejemplo: ¿podemos reconstruirla aproximadamente usando menos números? No quitando píxeles al azar, sino encontrando patrones que describan muchos de ellos a la vez.
Una imagen como suma de capas
La descomposición en valores singulares escribe una matriz como A = U Σ Vᵀ. Las columnas de U y V dan direcciones; la diagonal de Σ contiene valores singulares no negativos, ordenados de mayor a menor.
También podemos leerla como una suma de piezas: cada pieza es el producto de un vector columna y uno fila, multiplicado por su valor singular. Cada una tiene rango uno. Sumadas todas las piezas necesarias, reconstruyen la matriz; conservando las primeras k, obtenemos una aproximación de rango como máximo k.
Esta lectura es menos intimidante que tres letras juntas. Las primeras capas recogen patrones fuertes. Las siguientes pueden añadir contornos, pequeñas texturas o diferencias más sutiles. No son objetos semánticos: SVD no separa automáticamente «la casa», «el árbol» y «el cielo».
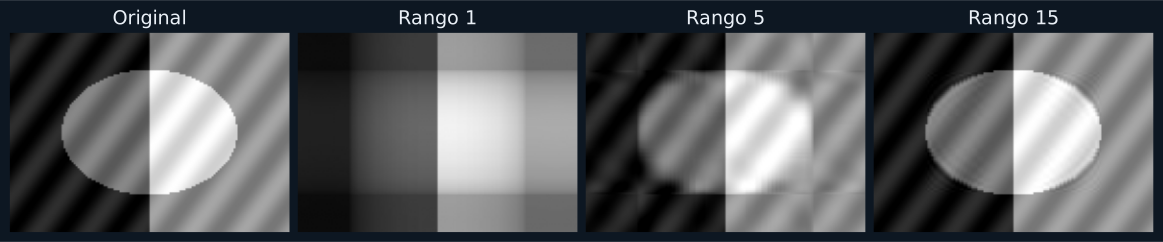
Al aumentar k la imagen suele parecerse más al original, pero «parecerse» necesita un criterio. La SVD truncada ofrece una aproximación óptima de rango limitado en normas matriciales como la de Frobenius. Eso mide diferencias numéricas, no lo importante que resulta un detalle para una persona.
Un pequeño texto puede ser esencial para leer una señal y aportar poca energía total a la imagen. El método no sabe que perder ese texto cambia el significado. Es la misma precaución de la primera parte: mucha variación conservada no significa toda la información útil conservada.
Hagámoslo sin una fotografía ajena
Para experimentar no necesitamos descargar imágenes ni reutilizar figuras de un libro. Podemos construir una matriz pequeña con una forma geométrica y algo de textura:
import numpy as np

y, x = np.mgrid[-1:1:100j, -1:1:140j]
A = .2 + .4 * (x > 0) + .3 * (x*x + y*y < .4)
A = A + .08 * np.sin(17*x + 9*y)
U, s, Vt = np.linalg.svd(A, full_matrices=False)
k = 5
approx = (U[:, :k] * s[:k]) @ Vt[:k]
print(np.linalg.norm(A - approx, "fro"))
El código produce una aproximación de la matriz, no un archivo comprimido listo para distribuir. Para visualizarla podemos fijar la misma escala de intensidad en el original y las reconstrucciones. Si cada panel ajusta automáticamente su contraste, el gráfico puede hacer que una aproximación mala parezca mejor de lo que es.
La matriz tiene 14.000 entradas. Guardar los factores truncados requiere k × (100 + 140 + 1) números: con cinco componentes, 1.205. Es una comparación de cantidades numéricas usando la misma precisión, no una promesa de reducción de bytes frente a PNG o JPEG. Esos formatos ya aplican otras técnicas y tienen sus propias estructuras.
Además, si reconstruimos la matriz completa y la guardamos sin un formato que conserve los factores, volvemos a almacenar todos sus píxeles. Haber utilizado menos componentes para calcularla no garantiza que el fichero resultante sea más pequeño.
La conexión con PCA
Para una matriz de observaciones centrada X, las direcciones principales pueden obtenerse de los vectores singulares derechos. Sus valores singulares al cuadrado, divididos por n − 1, corresponden a las varianzas de los componentes. Las coordenadas proyectadas son U Σ.
PCA y SVD no son sinónimos exactos. SVD factoriza una matriz cualquiera; PCA es un procedimiento estadístico sobre datos centrados, con decisiones de preprocesamiento e interpretación. En una imagen que aproximamos directamente no estamos haciendo necesariamente PCA sobre observaciones.
Esta conexión permite calcular PCA sin construir explícitamente la matriz de covarianzas. Es útil numéricamente y evita pensar en ambos métodos como recetas aisladas. La documentación de NumPy sobre SVD describe los factores y las dimensiones que devuelve la función utilizada aquí.
El residuo merece una mirada
En lugar de observar solo la reconstrucción, podemos mirar A − approx. ¿Qué desapareció? ¿Ruido, contornos, una estructura pequeña? En datos tabulares también podemos examinar el error por observación y por variable. Una media baja puede esconder que cierto grupo quedó mal representado.
No siempre necesitamos reducir dimensiones. A veces una representación original más extensa es más fácil de explicar y suficientemente barata. Tampoco conviene introducir PCA solo porque la tabla tenga muchas columnas; depende de redundancia, ruido, tamaño de muestra y objetivo.
Si algo conservaría de este recorrido es la costumbre de mirar ambos lados de una aproximación. El dibujo reconstruido cuenta lo que hemos retenido. El residuo cuenta el precio de haber simplificado. Sin ese segundo dibujo, es demasiado fácil confundir una representación compacta con una explicación completa.
¿Te ha resultado útil? Si te apetece apoyar este espacio, puedes invitarme a un café.
Invítame a un café Apoyo voluntario a través de PayPal. Tú eliges el importe.