A las ocho de la mañana hay sesenta bicicletas en la estación A, treinta en B y diez en C. Alguien necesita saber cuántas habrá disponibles después del siguiente periodo. No dónde acabará cada bicicleta, sino cómo se repartirá la flota.
Podríamos seguir cada vehículo y simular sus viajes. También podemos empezar por algo más pequeño: describir las probabilidades de pasar de una estación a otra. Una cadena de Markov convierte esa descripción en un modelo que podemos recorrer, calcular y discutir.
Todo lo que sigue es un ejemplo hipotético. Las probabilidades no proceden de un servicio real y el periodo es una unidad abstracta, no una hora calibrada con datos. Prefiero dejarlo claro antes de que un gráfico convincente dé al modelo una autoridad que no tiene.
Tres estados y una decisión de lectura
Vamos a suponer que una bicicleta en A tiene un 60 % de probabilidad de seguir en A, un 30 % de pasar a B y un 10 % de acabar en C. Desde B, las probabilidades son 20 %, 50 % y 30 %. Desde C, 40 %, 20 % y 40 %.
| Origen → destino | A | B | C |
|---|---|---|---|
| A | 0,60 | 0,30 | 0,10 |
| B | 0,20 | 0,50 | 0,30 |
| C | 0,40 | 0,20 | 0,40 |
Cada fila suma uno: una bicicleta debe acabar en alguno de los estados que hemos definido. Si los vehículos pueden salir del sistema o averiarse y no incluimos esos estados, la matriz no está describiendo toda la situación.
Usaré vectores fila, así que la evolución se escribe x(t+1) = x(t) P. También se puede trabajar con vectores columna y la matriz transpuesta. Ninguna convención es más inteligente; mezclarlas sí produce resultados incorrectos. Por eso conviene acompañar siempre la matriz con una frase: filas como origen, columnas como destino.
La suposición de Markov dice que, dado el estado actual, la distribución del siguiente no necesita toda la historia anterior. No significa que el pasado nunca importe en el mundo real. Significa que estamos intentando resumir lo necesario en el estado que hemos elegido.
Si una bicicleta recién reparada se comporta de manera distinta a otra con meses de uso, quizá «estar en A» no sea un estado suficientemente informativo. El modelo no descubre automáticamente esa carencia. Hay que detectar el patrón y ampliar la descripción o cambiar de enfoque.
El primer movimiento se puede calcular a mano
De las sesenta bicicletas iniciales en A esperamos que 36 sigan allí, 18 pasen a B y 6 a C. Las treinta de B aportan 6, 15 y 9. Las diez de C aportan 4, 2 y 4. Al sumar llegamos a 46 en A, 35 en B y 19 en C.
Es un reparto esperado. Una realización concreta podría ser 44, 38 y 18, por ejemplo; ese reparto ilustrativo no es una simulación ejecutada. La esperanza no compromete a cien vehículos individuales a obedecer una tabla.
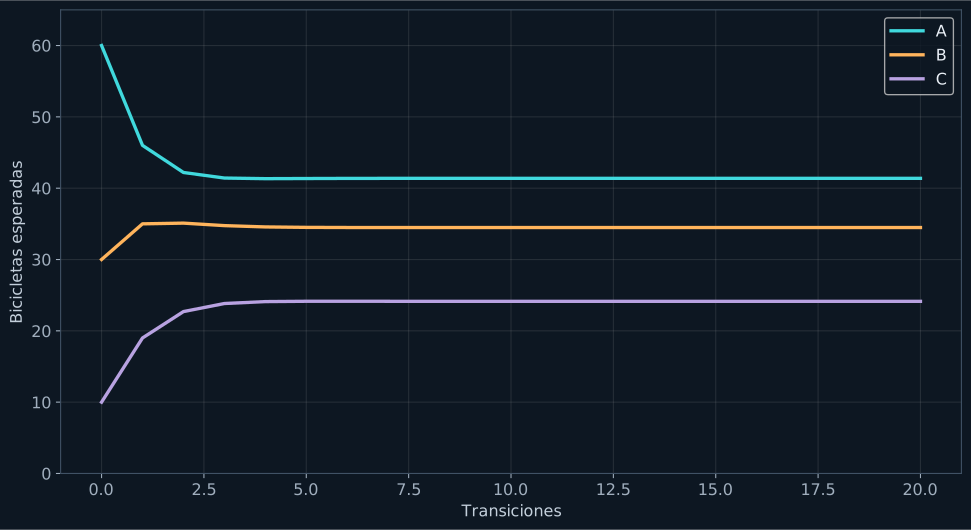
Esta distinción permite dos preguntas diferentes. Una es dónde se concentra la flota en promedio. Otra es la probabilidad de que una estación se quede sin bicicletas. La segunda exige estudiar la variabilidad; una curva de esperanzas no basta. Una estación con media de diez bicicletas puede tener un riesgo relevante de quedarse vacía, según cómo sean los viajes.
Para reproducir el primer paso basta una multiplicación:
import numpy as np

P = np.array([[.6, .3, .1], [.2, .5, .3], [.4, .2, .4]])
x = np.array([60., 30., 10.])
assert np.allclose(P.sum(axis=1), 1)
print(x @ P)  # [46. 35. 19.]
No hay entrenamiento, búsqueda de hiperparámetros ni una red neuronal escondida. El modelo está en las probabilidades que hemos puesto sobre la mesa. Esa transparencia es parte de su utilidad: podemos preguntar de dónde salió cada una y qué ocurriría si dejara de ser razonable.
Repetir no es adivinar
Para avanzar varios periodos multiplicamos otra vez por la misma matriz. Esa repetición supone probabilidades constantes: una cadena homogénea. Si por la mañana predominan los viajes hacia B y por la tarde los de vuelta, usar una sola matriz podría ocultar justamente el comportamiento que interesa.
Tampoco hemos modelado el número de plazas, las rutas compartidas ni las intervenciones de redistribución. En este ejemplo cada bicicleta evoluciona sin que la ocupación de una estación cambie sus probabilidades. Una estación llena rompe esa comodidad: no basta con seguir multiplicando y esperar que el sistema real encaje.
En mi simulador de movilidad puedes explorar la diferencia entre evolución esperada y trayectorias aleatorias. Es una buena manera de poner a prueba la intuición antes de convertir el modelo en una recomendación.
Nos falta una pregunta más incómoda. Aunque el reparto llegue a estabilizarse, ¿significa eso que tendremos una flota útil? En la segunda parte introduciremos un estado de avería. El equilibrio puede seguir siendo matemáticamente impecable y operativamente desastroso.
¿Te ha resultado útil? Si te apetece apoyar este espacio, puedes invitarme a un café.
Invítame a un café Apoyo voluntario a través de PayPal. Tú eliges el importe.