Abrimos una base de datos y vemos tablas. Filas, columnas y algunos identificadores. A primera vista, no parece tan diferente de una hoja de cálculo. Entonces, ¿por qué hablamos de un modelo relacional y no simplemente de una colección de tablas?
La diferencia está en lo que esas tablas significan y en las reglas que las acompañan. No basta con poder guardar un dato: necesitamos saber qué representa, qué valores puede tomar, cómo distinguirlo de los demás y qué conexiones son válidas.
Me parece más fácil entenderlo con algo pequeño que empezar memorizando definiciones. Vamos a construir una tienda ficticia. No hace falta conocer SQL para seguir el ejemplo; antes de escribir una consulta, nos interesa entender qué estamos consultando.
Una relación no es un enlace entre dos tablas
Esta sería nuestra información de clientes:
| cliente_id | nombre | ciudad | |
|---|---|---|---|
| 1 | Ana | ana@example.com | Sevilla |
| 2 | Bruno | bruno@example.com | Bilbao |
| 3 | Carla | carla@example.com | Sevilla |
| 4 | Diego | diego@example.com | Valencia |
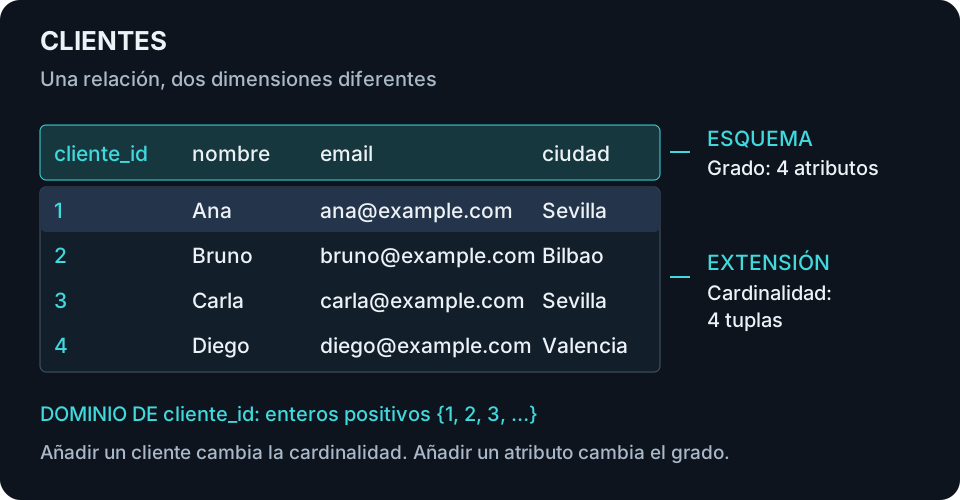
En el modelo relacional, CLIENTES es una relación. Podemos visualizarla como una tabla, pero el concepto no se refiere al enlace que luego estableceremos con los pedidos. Esta confusión es bastante comprensible: en el lenguaje cotidiano, «relación» suele significar conexión; aquí nombra la estructura que contiene los datos.
Cada fila es una tupla. La primera recoge un hecho: existe un cliente identificado con el número 1, llamado Ana, con ese correo y esa ciudad. Cada columna corresponde a un atributo: nombre indica qué papel tiene el valor «Ana» dentro de ese hecho. Sin nombres de atributos, veríamos valores, pero no sabríamos interpretarlos.
Podemos escribir la misma tupla como ⟨1, Ana, ana@example.com, Sevilla⟩, siempre que hayamos indicado antes a qué atributo corresponde cada posición. La notación es una manera compacta de mostrar el dato, no una obligación de almacenar físicamente los valores en ese orden.
El dominio: los valores que tienen sentido
Un atributo no debería aceptar cualquier cosa. Su dominio es el conjunto de valores atómicos que puede tomar. «Atómico» significa que, en este modelo, tratamos cada valor como una unidad, no como una colección de otros valores que la base deba recorrer.
Para cliente_id podríamos definir el dominio de los enteros positivos. Para nombre, un dominio de textos no vacíos. Para email, textos que cumplan las condiciones que acordemos para un correo. No todos los valores posibles de un tipo informático pertenecen necesariamente al dominio que necesitamos.
Un ejemplo más claro aparece en los pedidos: si estado solo puede ser pendiente, pagado o cancelado, su dominio contiene esos tres valores. «Azul» es una cadena de caracteres perfectamente válida como texto, pero no es un estado válido para nuestra tienda.
Hay dominios predefinidos —enteros, textos, fechas— y dominios definidos por quien diseña la base de datos, más específicos. Un tipo como INTEGER nos da una primera frontera; una condición como «mayor que cero» la estrecha.
Dominio y atributo tampoco son sinónimos. telefono_personal y telefono_trabajo pueden compartir un dominio de números de teléfono y, aun así, expresar dos cosas distintas. El dominio dice qué valores admitimos; el atributo dice qué significan en ese lugar.
Esto también explica por qué almacenar "600111222, 600333444" en una celda no es una buena representación de dos teléfonos que queremos consultar por separado. Hemos convertido una colección en un texto que después habrá que interpretar. Si necesitamos gestionar cada teléfono, podemos representarlos en otra relación, con una tupla por teléfono y cliente. No es que una cadena larga deje de ser atómica por tener comas; el problema es usarla para esconder varios hechos que queremos tratar individualmente.
Esquema y extensión: el molde y su contenido
El esquema de una relación, también llamado intensión, describe su estructura. Se suele representar mediante el nombre de la relación y sus atributos:
CLIENTES(cliente_id, nombre, email, ciudad)Para definirla por completo también necesitamos asociar los dominios y establecer sus claves y restricciones. La extensión es el conjunto de tuplas que contiene en un momento determinado: en nuestro caso, las cuatro filas de la tabla.
Si mañana se registra Elena, cambia la extensión. Si añadimos un atributo fecha_alta, cambia el esquema. Una cosa es incorporar otro cliente; otra, decidir que a partir de ahora guardaremos una información que antes no existía en la estructura.
Una relación puede estar vacía y conservar su esquema. Una tienda recién creada puede tener CLIENTES sin ninguna tupla: seguimos sabiendo qué información admitirá cuando llegue el primer cliente.
No hay que confundir este esquema con el de toda la base de datos. El esquema de la base reúne las definiciones de sus relaciones y las restricciones que las conectan. Además, algunos gestores utilizan la palabra schema para un espacio de nombres que agrupa tablas y otros objetos. El contexto importa.
Grado y cardinalidad: columnas no son filas
El grado de una relación es el número de atributos de su esquema. CLIENTES tiene grado 4. La cardinalidad de una relación es el número de tuplas de su extensión: ahora también es 4, pero esa coincidencia es accidental.
Si añadimos cien clientes, el grado seguirá siendo 4 y la cardinalidad pasará a 104. Si añadimos fecha_alta sin registrar a nadie más, el grado será 5 y la cardinalidad seguirá siendo 4.
La palabra cardinalidad también aparece al hablar de asociaciones uno a muchos. Ahí describe cuántas entidades pueden participar en una asociación; aquí estamos contando las tuplas de una relación concreta. Son usos distintos de la misma palabra.
Lo que una relación no promete
La extensión es un conjunto, así que en el modelo relacional no hay tuplas repetidas. Eso no significa que cada columna deba tener valores diferentes: Ana y Carla viven en Sevilla. Lo que no puede repetirse es la tupla completa.
Tampoco existe una «primera tupla» por naturaleza. Cambiar el orden visual de las filas no cambia la relación. Si queremos mostrar los clientes por nombre, debemos solicitar ese orden. Los atributos se identifican por su nombre y tampoco tienen un orden lógico obligatorio, aunque al escribir una tabla o una tupla elijamos una disposición para leerla.
Conviene separar esta teoría del funcionamiento de SQL. Una tabla SQL sin restricciones puede admitir filas duplicadas, y una consulta puede devolver duplicados aunque las tablas de origen tengan claves. DISTINCT elimina duplicados del resultado; ORDER BY define su orden de presentación. La documentación de PostgreSQL sobre listas de selección explica el primer comportamiento. Una tabla SQL no cumple automáticamente todas las propiedades de una relación teórica por tener aspecto de tabla.
Identificar no es lo mismo que describir
Hoy todos nuestros clientes tienen nombres diferentes. ¿Podemos usar nombre como clave? No, si la tienda permite que mañana se registre otra Ana. Una clave debe funcionar para los estados válidos de la base de datos, no solo para las cuatro filas que casualmente tenemos delante.
Una superclave es un conjunto de atributos que permite identificar de forma única cada tupla. Si cliente_id es único, tanto {cliente_id} como {cliente_id, nombre} son superclaves. La segunda funciona, pero incluye un atributo que no necesitamos para identificar.
Una clave candidata es una superclave mínima: al quitarle cualquiera de sus atributos, deja de identificar de forma única. Mínima no significa «la más corta entre todas las claves», sino «sin atributos sobrantes dentro de esa clave».
Supongamos que nuestra tienda exige además un correo único y obligatorio por cliente. Entonces {cliente_id} y {email} serían claves candidatas. Elegimos {cliente_id} como clave primaria, y {email} queda como clave alternativa. Si permitiéramos correos compartidos, el correo dejaría de servir como clave candidata; la decisión depende de las reglas del sistema.
Una clave puede ser compuesta. En LINEAS_PEDIDO, la pareja {pedido_id, numero_linea} podría identificar cada línea: el pedido 101 puede tener una línea 1 y el 102 también, pero no puede haber dos líneas 1 dentro del mismo pedido. Ningún atributo aislado basta; juntos, sí.
Nos falta una pieza: impedir que aparezca un pedido de un cliente inexistente o un importe que nuestra tienda no acepta. Eso ya no es una cuestión de cómo dibujar la tabla, sino de qué estados de la base de datos consideramos válidos. A eso está dedicada la segunda parte.
¿Te ha resultado útil? Si te apetece apoyar este espacio, puedes invitarme a un café.
Invítame a un café Apoyo voluntario a través de PayPal. Tú eliges el importe.