En una publicación de LinkedIn planteé una pregunta que aparece muy pronto al trabajar con modelos: ¿cuándo normalizar y cuándo estandarizar? La respuesta corta cabe en una tarjeta. La útil necesita un poco más de espacio.
Cuando retomé el tema para este artículo, me pareció importante afinar algunas simplificaciones de aquel texto. Estandarizar no vuelve normal una distribución. La regresión logística y SVM no exigen, en general, que cada variable siga una distribución gaussiana. Y utilizar media y desviación típica tampoco convierte al escalador estándar en resistente a outliers.
La pregunta sigue siendo buena. Lo que prefiero cambiar es el punto de partida: antes de escoger una transformación, entender qué va a hacer el algoritmo con las diferencias entre observaciones.
Dos clientes, dos unidades
Imagina que buscamos clientes parecidos usando edad e ingresos anuales. Una diferencia de diez años y otra de diez mil euros llegan a una distancia euclídea como diez y diez mil. El ingreso domina numéricamente, aunque todavía no hayamos decidido cuánto debería pesar cada atributo.
Si expresamos los ingresos en miles de euros, esa misma diferencia pasa a valer diez. No cambió el cliente; cambió la geometría que presentamos al modelo. Ese es el problema que intenta resolver el escalado cuando ponemos variables con unidades diferentes en una misma comparación.
No todos los algoritmos responden igual. Los vecinos más cercanos y k-means dependen directamente de distancias. En SVM con kernel RBF, la escala afecta a las distancias que utiliza el kernel. En modelos lineales regularizados, también influye en cómo se aplica la penalización a los coeficientes. Los árboles de decisión suelen ser mucho menos sensibles a transformaciones monótonas de una variable, porque dividen según umbrales, aunque su implementación y el resto del pipeline siguen importando.
Por tanto, no escalar también es una opción. Pero debe ser una opción razonada, no el resultado de olvidar el paso.
Si necesitas un rango
El escalado min-max convierte cada valor mediante (x − mínimo) / (máximo − mínimo), normalmente para situar el entrenamiento entre cero y uno. Es una transformación sencilla de interpretar: cero corresponde al mínimo observado y uno al máximo.
Aquí llamaré normalización a ese escalado, como hacía en mi publicación. La palabra también se usa para normalizar vectores a norma unitaria, por ejemplo al comparar ciertas representaciones. Es otra operación. Conviene decir «min-max» cuando la ambigüedad pueda importar.
No necesitamos una distribución no normal para usar min-max. Necesitamos que ese rango tenga sentido para el uso posterior. Tampoco garantiza que cualquier dato futuro quede entre cero y uno: una observación que supere el máximo del entrenamiento puede transformarse en un valor mayor que uno. Recortarla es otra decisión, y puede ocultar un cambio relevante.
Si necesitas centrar y comparar dispersión
La estandarización transforma mediante (x − media) / desviación típica. En las variables no constantes del conjunto con el que se ajusta, obtenemos media cero y varianza uno, según la convención del cálculo. No hemos eliminado asimetría, colas ni varios grupos dentro de la distribución.
Su interpretación es distinta a min-max: un valor de dos indica dos desviaciones típicas por encima de la media del entrenamiento. Puede ser útil aunque la distribución no sea gaussiana. La elección depende del modelo y del significado de esa escala, no de superar una prueba de normalidad como requisito universal.
Aparece un cliente extraordinario
Añadamos a los ingresos varios valores ordinarios y uno enorme. Min-max utiliza ese máximo, así que comprime el grupo ordinario cerca de cero. StandardScaler también cambia: el valor extremo desplaza la media y aumenta la desviación típica. Ninguno es una solución automática al problema.
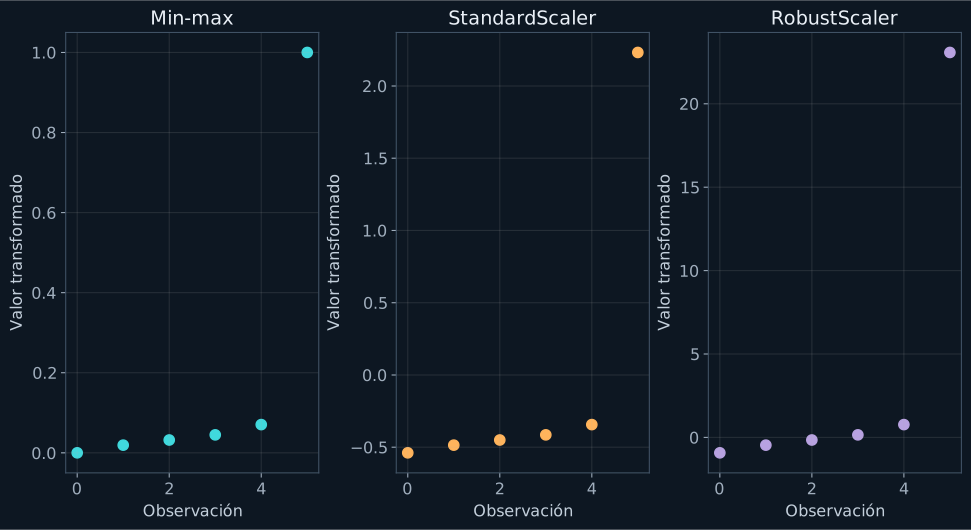
RobustScaler utiliza la mediana y, por defecto, el rango intercuartílico. Esos estadísticos suelen estar menos afectados por valores extremos que media y desviación típica. Aun así, no borra los outliers ni garantiza un buen modelo. Puede dejarlos muy lejos del grupo central, y eso será deseable o problemático según el objetivo.
La documentación de preprocesamiento de scikit-learn distingue estas alternativas. Cuando importa el efecto concreto, prefiero visualizar la transformación antes de quedarme con la etiqueta «robusta».
También hay que decidir qué representa ese cliente extraordinario. ¿Un error de unidades? ¿Una persona real muy distinta? ¿Una población que deberíamos analizar por separado? Cambiar la escala puede mejorar una geometría, pero no responde a esas preguntas de calidad y contexto.
El momento de ajustar importa tanto como la fórmula
Media, desviación, mínimo y máximo se aprenden de los datos. Si calculamos esos parámetros con el conjunto completo antes de separar entrenamiento y test, dejamos que la evaluación influya en una parte del proceso.
La opción práctica es incluir la transformación en un pipeline. Durante validación cruzada, se ajustará dentro de cada partición de entrenamiento; sobre validación o test solo se aplicará lo aprendido.
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.neighbors import KNeighborsClassifier

model = make_pipeline(StandardScaler(), KNeighborsClassifier(n_neighbors=5))
# X_train e y_train son exclusivamente la partición de entrenamiento.
model.fit(X_train, y_train)
predictions = model.predict(X_test)
Para reproducirlo necesitamos un problema con etiquetas y una separación apropiada; el fragmento muestra el orden, no una evaluación ya realizada. Si las observaciones son temporales o se repiten por persona, la división requiere más cuidado que un reparto aleatorio.
Un escalador guarda parámetros que forman parte del sistema. Al desplegar un modelo debemos conservarlos y aplicarlos igual. Recalcular la media con cada lote nuevo cambia la representación que recibe un modelo ya entrenado. Puede hacerse en un diseño específico, pero no como accidente.
La respuesta que daría ahora
Si alguien me pide elegir, empezaría por el algoritmo y las unidades. Después miraría rangos, valores extremos y distribución. Si necesito límites numéricos conocidos, estudiaría min-max y qué hacer fuera del rango. Si quiero centrar variables y comparar dispersión, probaría estandarización. Si hay extremos influyentes, revisaría su origen y consideraría un escalado robusto.
Compararía las opciones mediante el mismo protocolo y dejaría el test final apartado. No elegiría una receta distinta después de cada resultado hasta encontrar el que me gusta. También comprobaría variables constantes, porque dividir por una dispersión nula no tiene la interpretación habitual, aunque una librería gestione el caso sin lanzar un error.
Hay una pregunta que me ayuda a terminar: si mañana cambiamos euros por miles de euros, ¿queremos que cambie el resultado? Si la respuesta es no, el tratamiento de la escala tiene que reflejarlo. Si la respuesta es sí porque esa magnitud representa algo importante, debemos poder explicar por qué. Esa conversación suele ser más productiva que discutir cuál de los dos nombres suena más correcto.
¿Te ha resultado útil? Si te apetece apoyar este espacio, puedes invitarme a un café.
Invítame a un café Apoyo voluntario a través de PayPal. Tú eliges el importe.