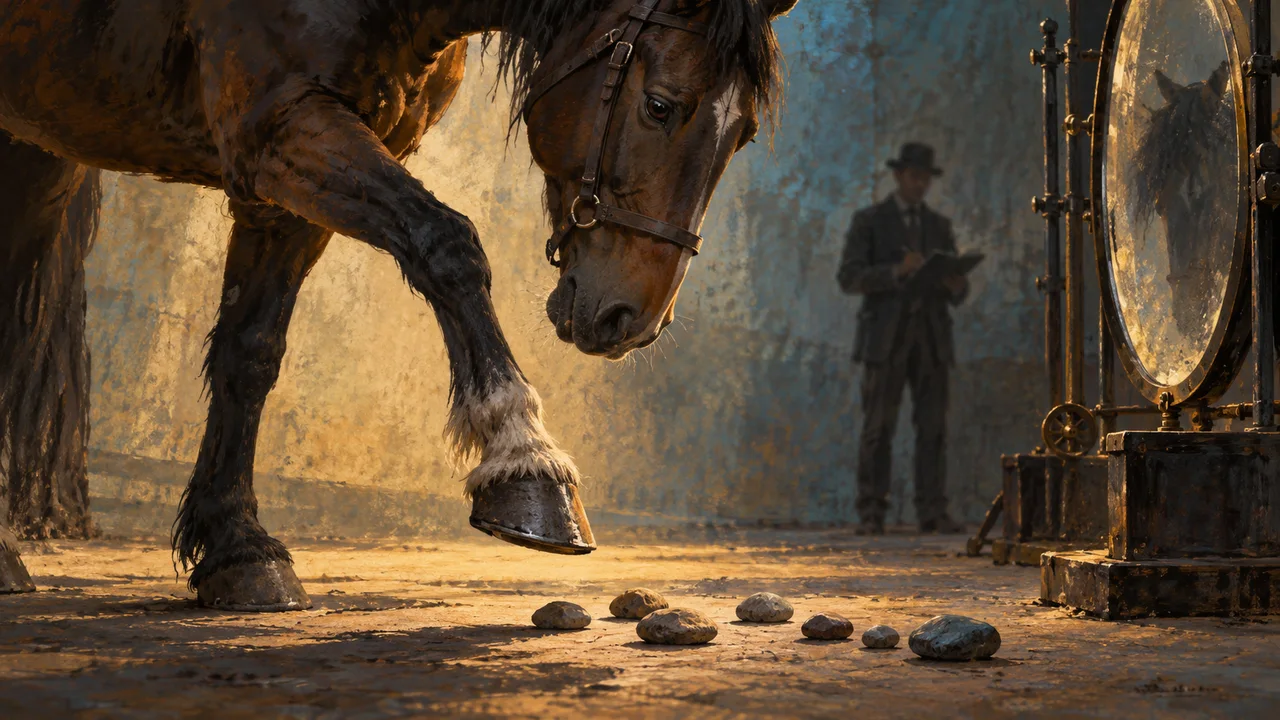
El caballo parecía saber matemáticas. Le preguntaban una operación y respondía golpeando el suelo con la pezuña. Los espectadores contaban los golpes; cuando llegaba al resultado correcto, se detenía. Para quienes lo observaban, la evidencia estaba delante: pregunta, respuesta, acierto.
Clever Hans se hizo famoso a comienzos del siglo XX. Lo interesante de su historia no es burlarse de quienes creyeron en él. Es que comprobar que no había un engaño deliberado tampoco bastó para explicar qué estaba ocurriendo. El caballo seguía acertando sin su entrenador, y eso parecía reforzar la interpretación de que calculaba.
Los controles de Oskar Pfungst cambiaron la pregunta. ¿Qué ocurría si quien preguntaba no conocía la respuesta? ¿Y si Hans no podía verle? El rendimiento dejaba de sostenerse. El caballo había aprendido a responder a señales sutiles del observador, no a realizar las operaciones que le atribuían.
Un siglo después, esa distancia entre lo que observamos y lo que creemos haber demostrado vuelve a resultar incómoda al evaluar inteligencia artificial. Una respuesta correcta puede ser útil y, a la vez, decir menos de lo que nos gustaría sobre la capacidad del sistema.
Melanie Mitchell utiliza este tipo de casos en «Six principles for evaluating cognitive capabilities in AI models». Su propuesta no consiste en declarar que los modelos son incapaces de razonar. Pide controles antes de convertir un buen resultado en una afirmación amplia sobre comprensión, razonamiento o inteligencia.
La cifra que llega antes que la pregunta
«El modelo acertó noventa de cien problemas». Esa frase describe una observación. «El modelo comprende el concepto» propone una explicación. Entre ambas falta demostrar que la prueba mide ese concepto y que otras estrategias no explican los aciertos.
En evaluación se habla de validez de constructo. Un constructo es la capacidad que queremos estudiar, por ejemplo razonamiento analógico. La prueba contiene conductas observables que deberían aportar evidencia sobre ella. Poner «razonamiento» en el nombre del benchmark no garantiza esa relación.
Imagina una prueba ficticia que pide continuar secuencias. Si todas las respuestas correctas son la opción más larga, el sistema podría explotar ese detalle. Si los ejemplos circulan por internet, podría reconocer versiones cercanas. Y si una pregunta nueva se parece mucho a otra conocida, no necesitamos una copia literal para tener una explicación alternativa.
El resultado seguiría siendo un acierto en la prueba. Lo que cambia es cuánto podemos generalizar a otras situaciones. Para alguien que construye una aplicación, esa diferencia importa: un asistente que funciona con plantillas conocidas puede fallar en cuanto el usuario plantea el problema de otra forma.
Me parece más útil preguntar «¿en qué condiciones funciona?» que intentar resolver de una vez si una máquina piensa como una persona. La primera pregunta permite diseñar una evaluación; la segunda puede consumir mucha conversación sin cambiar una sola prueba.
Seis principios, llevados a una mesa de trabajo
Los seis principios de Mitchell pueden convertirse en hábitos de revisión. No son una nueva puntuación ni una garantía de que descubriremos el mecanismo interno del modelo.
Reconocer nuestro sesgo antropomórfico. Una explicación fluida nos invita a atribuir intención y comprensión. Conviene traducir esa impresión a una hipótesis comprobable: qué tarea debe resolver el sistema, con qué información y frente a qué variantes.
Probar explicaciones alternativas. Si una pista superficial podría bastar para acertar, quitamos esa pista. Es el movimiento decisivo en el caso de Hans: no repetir el espectáculo, sino cambiar una condición que separa dos posibles explicaciones.
Crear variaciones novedosas. Podemos cambiar nombres, símbolos o contexto manteniendo la relación que queremos evaluar. Si el resultado cae, hay algo que investigar. También debemos comprobar que la variante no haya añadido una dificultad real que antes no existía.
Investigar cómo aparece el acierto. Los patrones de respuesta y las intervenciones controladas aportan evidencia adicional. Una explicación verbal del modelo puede ser otra conducta que estudiar; no es una ventana infalible a sus procesos internos.
Separar competencia y rendimiento. Un fallo puede deberse a la capacidad que buscamos medir, pero también al formato, la percepción o la ejecución. Si el sistema identifica una transformación de una cuadrícula y no consigue dibujarla, interesa distinguir ambas tareas.
Estudiar errores y resultados negativos. Las respuestas que no encajan pueden revelar familias de fallos. Si las escondemos detrás de la media, perdemos información útil y terminamos documentando solo lo que salió bien.
Un pequeño experimento antes de una gran conclusión
Pensemos en un asistente ficticio que debe decidir si una reserva cumple una regla de cancelación. La regla se entrega en el contexto; no esperamos que la conozca de memoria. Queremos comprobar si aplica correctamente las condiciones.
Prepararía primero casos sencillos cuyo resultado pueda verificar una persona: cancelación dentro y fuera de plazo, una excepción explícita y un caso donde falta la fecha necesaria. Después crearía parejas de variantes. Cambiaría el nombre del hotel, reordenaría frases o usaría fechas distintas que conservaran la misma relación temporal.
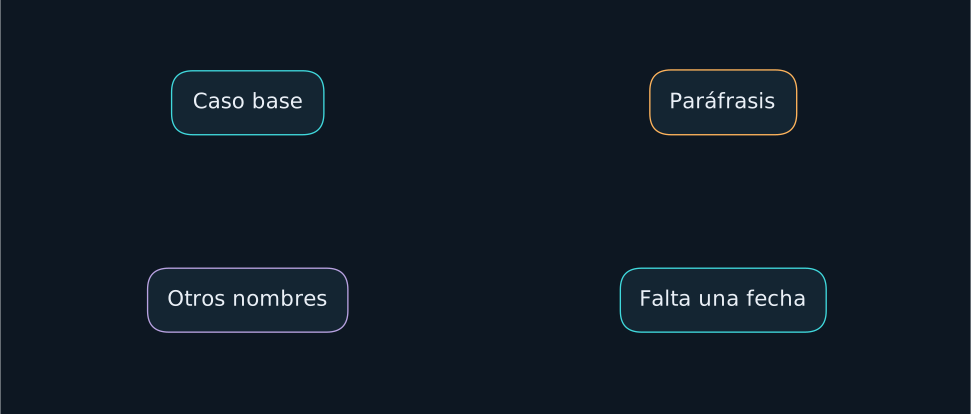
En el caso incompleto, inventar una fecha sería un fallo aunque la decisión coincidiera por casualidad con la respuesta esperada. Eso obliga a revisar qué métrica usamos. Una exactitud binaria que solo mire «permitir / denegar» puede pasar por alto que el sistema fabricó evidencia.
Repetiría los casos bajo una configuración registrada: versión del modelo, instrucciones, parámetros y fecha de ejecución real. Conservaría entradas y respuestas. Miraría tanto el resultado agregado como las diferencias entre variantes. No publicaría cifras de este ejemplo sin ejecutar antes ese protocolo.
Si falla únicamente al cambiar nombres, investigaría un posible atajo. Si falla con fechas en un formato concreto, podría haber una dificultad de interpretación. Si responde de forma distinta a la misma entrada, estudiaría consistencia. Son hipótesis, no diagnósticos definitivos: necesitamos nuevos controles para separarlas.
Lo que escribiría en el informe
Evitaría una conclusión como «el modelo entiende políticas». Escribiría algo más acotado: qué reglas recibió, qué familias de casos se probaron, qué variaciones mantuvo y dónde falló. Si detecta bien la falta de información pero se equivoca con excepciones, esa diferencia merece aparecer en el resumen, no perderse en un anexo.
También distinguiría robustez, generalización y consistencia. Cambiar una palabra irrelevante estudia una clase de robustez. Probar otra familia de políticas plantea transferencia. Repetir la misma entrada examina estabilidad. Son preguntas relacionadas, pero no intercambiables.
Esto no convierte todos los benchmarks en inútiles. Sirven para comparar resultados bajo condiciones conocidas. El problema aparece cuando la conclusión se aleja tanto de esas condiciones que la cifra termina sosteniendo una historia que la prueba nunca puso a examen.
La historia de Hans deja una lección bastante práctica: el control más valioso puede ser el que estropea la demostración. Si el sistema deja de acertar cuando quitamos una pista accidental, hemos aprendido algo. Y ese aprendizaje es más útil para construir una aplicación fiable que otro porcentaje brillante sin explicación.
¿Te ha resultado útil? Si te apetece apoyar este espacio, puedes invitarme a un café.
Invítame a un café Apoyo voluntario a través de PayPal. Tú eliges el importe.