Imagina que una empresa recibe cientos de candidaturas y utiliza un modelo para ordenarlas. El sistema trabaja rápido y sus recomendaciones se parecen mucho a las contrataciones de años anteriores. Desde el punto de vista de la predicción, parece funcionar.
Pero hay una pregunta pendiente: ¿y si aquellas contrataciones ya dejaban fuera a personas igualmente capacitadas? El modelo puede aprender muy bien una decisión que no deberíamos seguir repitiendo.
Este ejemplo es inventado, pero sirve para situar el problema. La ética de la IA no consiste en poner una lista de buenas intenciones al final de un proyecto. Consiste en preguntarnos qué estamos convirtiendo en objetivo, qué personas sufrirán los errores y quién podrá cuestionar el resultado. Una métrica no responde por nosotros.
Primero, qué significa «hacerlo bien»
Cuando hablamos de una IA responsable, conviene separar preguntas que a veces colocamos en el mismo saco. Un sistema puede ser preciso, pero invasivo. Puede ser fácil de explicar, pero discriminatorio. Y puede respetar una obligación legal concreta sin resolver todos sus problemas éticos.
La equidad y la no discriminación obligan a mirar algo más que el promedio. En el ejemplo de contratación, revisaría si el modelo descarta sistemáticamente ciertos perfiles, cómo se recogieron las candidaturas y qué significa la etiqueta «buen candidato». Haber sido contratado no demuestra por sí solo que alguien fuera la mejor opción. Eliminar una columna sensible tampoco elimina todas sus huellas: otras variables pueden funcionar como sustitutos.
La privacidad empieza antes de entrenar. ¿Necesitamos realmente toda la información del currículum? ¿Tiene sentido conservarla indefinidamente? Cambiar el nombre por un código es seudonimizar, no demostrar anonimato: si podemos volver a identificar a la persona, seguimos teniendo datos personales.
La transparencia permite saber que se está usando IA, con qué finalidad y con qué limitaciones. La interpretabilidad se refiere a poder comprender el comportamiento del modelo. La explicabilidad busca ofrecer una explicación útil de un resultado, incluso cuando el modelo no es directamente interpretable. Publicar código no garantiza ninguna de las tres para una persona que necesita entender por qué quedó fuera.
La responsabilidad y la rendición de cuentas requieren nombres, funciones y procedimientos. «Lo decidió el algoritmo» no identifica quién eligió los datos, quién aprobó el uso ni quién tiene autoridad para corregirlo.
Por último, el beneficio social y la no maleficencia nos hacen comparar la utilidad con los daños previsibles. Ahorrar tiempo puede ser valioso; convertir un rechazo injusto en un rechazo injusto más rápido no es una mejora suficiente. También cuentan la accesibilidad y los recursos que consume la solución: quizá una herramienta más sencilla resuelva el problema con menos riesgos.
Estos principios entran en tensión. Recoger información sobre grupos puede ayudar a investigar diferencias de trato, pero introduce riesgos de privacidad. La salida no es elegir una palabra —«equidad» o «privacidad»— y dar el debate por cerrado. Hay que justificar qué datos se necesitan, qué tratamiento es lícito y cómo se protegerán.
La articulación legal: no existe una única «ley de los algoritmos»
Un proyecto de IA puede quedar sujeto a varias normas a la vez. El AI Act se ocupa de sistemas y modelos de IA; el RGPD, del tratamiento de datos personales. Las normas laborales, de consumo, de propiedad intelectual o de seguridad de productos pueden añadir obligaciones según el uso.
La pregunta práctica no es «¿cuál de estas leyes elijo?», sino «¿cuáles se aplican a esta actividad y cómo encajan?». Usar un modelo de un proveedor externo no borra las obligaciones de quien construye la aplicación o decide utilizarla.
También hay que distinguir una ley de un estándar técnico o una recomendación ética.
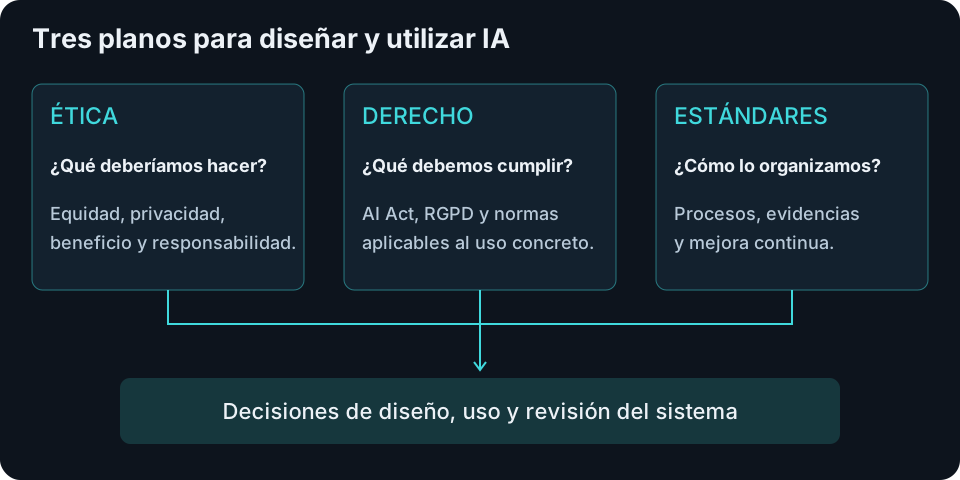
El contenido jurídico de este artículo se ha revisado el 5 de octubre de 2026. Es una introducción divulgativa, no un dictamen de cumplimiento para un producto concreto. El ámbito, las excepciones y los plazos deben comprobarse en los textos vigentes.
AI Act: importa para qué se utiliza el sistema
El llamado AI Act es el Reglamento (UE) 2024/1689, no una propuesta pendiente de aprobar. Su enfoque se basa en el riesgo: no trata igual una aplicación que recomienda música y otra que influye en el acceso a un empleo.
Una forma de orientarse es distinguir estos casos:
| Situación | Qué debemos entender |
|---|---|
| Prácticas prohibidas | Hay usos que no se legitiman simplemente añadiendo controles. |
| Sistemas de alto riesgo | Su finalidad puede exigir requisitos específicos antes y durante su utilización. |
| Obligaciones de transparencia | Determinadas interacciones o contenidos requieren información sobre su carácter artificial. |
| Otros usos | No entran por ello en todas las obligaciones anteriores, pero siguen sujetos a las normas que les correspondan. |
Es un mapa para empezar, no cuatro casillas que resuelven cualquier producto. Las obligaciones pueden solaparse, y los modelos de uso general tienen además un régimen propio.
Entre las prohibiciones figuran determinadas formas de manipulación perjudicial y puntuación social. También existen restricciones específicas sobre usos biométricos. No conviene resumirlo como «todo reconocimiento facial está prohibido»: importan la práctica, el contexto y las excepciones legales. Los requisitos de un sistema permitido de alto riesgo y las prohibiciones son categorías distintas.
La selección y evaluación de candidaturas es uno de los usos contemplados en el anexo III. Para clasificar una aplicación concreta hay que examinar su finalidad y las condiciones del artículo 6. No es suficiente decir que «solo usa un modelo pequeño» o que «la última palabra la tiene una persona».
El texto del AI Act permite consultar esas distinciones. En un proyecto de alto riesgo, la preparación incluye gestionar riesgos, gobernar los datos, documentar el sistema, registrar su funcionamiento y diseñar una supervisión efectiva. No equivale a prometer que el modelo nunca se equivocará.
Un chatbot y un modelo fundacional no son lo mismo
Un chatbot de atención debe analizar las obligaciones de informar de la interacción con IA. En contenidos sintéticos, el artículo 50 distingue obligaciones de proveedores y responsables del despliegue, con condiciones y excepciones. No exige de la misma manera un aviso visible en cada texto que haya recibido cualquier ayuda de IA. La Comisión explica estos matices en sus directrices de transparencia.
Por otra parte, los modelos de IA de uso general, o GPAI, tienen obligaciones propias para sus proveedores, incluidas cuestiones de documentación y derechos de autor; los de riesgo sistémico añaden medidas específicas. Esa capa no sustituye la evaluación de la aplicación que se construye sobre el modelo. La visión general de la Comisión ayuda a separar ambas.
No todo empezó a aplicarse el mismo día
La entrada en vigor y la aplicación de obligaciones no son lo mismo. Además, el calendario se ha modificado: el Reglamento (UE) 2026/1744, conocido como AI Omnibus, entró en vigor el 27 de julio de 2026.
| Hito | Fecha de referencia |
|---|---|
| Aplicación de las prohibiciones iniciales | 2 de febrero de 2025 |
| Aplicación del régimen de modelos de uso general | 2 de agosto de 2025 |
| Aplicación general, incluidas las obligaciones de transparencia, con excepciones y transiciones | 2 de agosto de 2026 |
| Aplicación de los bloques principales de requisitos y obligaciones de alto riesgo para sistemas del anexo III | 2 de diciembre de 2027 |
| Aplicación de esos bloques para los sistemas del artículo 6.1 vinculados al anexo I | 2 de agosto de 2028 |
La tabla no recoge todos los supuestos transitorios ni cada obligación. Por ejemplo, el régimen de modelos ya comercializados y determinadas medidas tienen sus propias condiciones. Para preparar un lanzamiento, comprobaría el calendario oficial actualizado, no una infografía antigua que dé por aplicable todo el reglamento desde agosto de 2026.
El RGPD sigue ahí, aunque el modelo venga de una API
Si procesamos datos personales, el Reglamento (UE) 2016/679, o RGPD, sigue siendo relevante. No hace falta una red neuronal para que se aplique, ni deja de hacerlo porque llamemos «prompt» a un texto que contiene información de una persona.
En la práctica hay que justificar la base jurídica, limitar la finalidad y los datos utilizados, informar y protegerlos. El consentimiento no es la única base jurídica, ni una autorización universal para cualquier reutilización. El artículo 6 contempla distintas bases; los datos de categorías especiales requieren además analizar el artículo 9. Estas cuestiones pueden consultarse en el RGPD publicado en el BOE.
Para nuestro sistema de candidaturas, enviaría al equipo de privacidad una descripción concreta del flujo: qué información sale de la organización, quién la recibe, para qué la conserva y si hay transferencias internacionales. Contratar una API no responde automáticamente a esas preguntas.
El artículo 22 aborda decisiones basadas únicamente en tratamiento automatizado que producen efectos jurídicos o afectan de manera similar y significativa. Tiene excepciones y garantías; no prohíbe toda recomendación de un modelo. Tampoco basta con que alguien pulse «aceptar» para convertir una decisión en revisión humana real. Las directrices alojadas por la AEPD sobre decisiones automatizadas exigen una intervención significativa, con competencia y autoridad para cambiar el resultado.
Una evaluación de impacto en protección de datos —EIPD— es necesaria cuando el tratamiento probablemente implique un alto riesgo para los derechos y libertades, conforme al artículo 35. No debe confundirse con la evaluación de impacto en derechos fundamentales del artículo 27 del AI Act: esta última corresponde a determinados responsables del despliegue y usos, no automáticamente a cualquier proyecto de IA. Pueden coordinarse, pero no son una única evaluación con dos nombres.
Qué otras normas pueden entrar en la conversación
En España, la Ley Orgánica 3/2018, o LOPDGDD, complementa el marco del RGPD. No es una alternativa que permita escoger el régimen más cómodo.
El Reglamento de Servicios Digitales, o DSA, introduce obligaciones para servicios intermediarios y plataformas dentro de su ámbito, incluidas cuestiones de transparencia de sistemas de recomendación. No es una regulación genérica aplicable por igual a cualquier chatbot. Las preguntas y respuestas de la Comisión sobre el DSA explican ese alcance.
La propiedad intelectual importa tanto al reunir datos de entrenamiento como al usar documentos en un sistema RAG. Que un archivo sea accesible en internet no significa que tenga permiso ilimitado de reutilización. En España, el Real Decreto-ley 24/2021 regula supuestos de minería de textos y datos, con condiciones y posibles reservas de derechos. No sustituiría la revisión de licencias por «el modelo puede leerlo».
Y luego están las normas del sector: empleo, salud, productos o servicios financieros. La calificación de una herramienta como IA no borra los derechos que ya existían en esos ámbitos. Si el sistema decide sobre candidaturas, el análisis no debería quedarse en un checklist tecnológico.
ISO y principios éticos: una ayuda, no un salvoconducto
La ISO/IEC 42001:2023 establece requisitos para un sistema de gestión de IA. Ayuda a organizar políticas, responsabilidades, riesgos y mejora continua. La ISO/IEC 38507:2022 trata las implicaciones de gobernanza del uso de IA en las organizaciones.
No son leyes por sí mismas ni equivalen a una declaración automática de conformidad de cualquier aplicación. Su exigibilidad puede depender de contratos o de su incorporación a requisitos concretos. Una certificación de gestión tampoco demuestra que cada predicción sea justa.
La Recomendación de la UNESCO sobre ética de la IA aporta otro plano: derechos humanos, proporcionalidad, supervisión y responsabilidad como orientación. Una recomendación ética no funciona como un reglamento con las mismas obligaciones y sanciones.
Lo útil es traducir cada instrumento a trabajo verificable. Si hablamos de transparencia, debe existir información comprensible. Si hablamos de responsabilidad, debe existir una persona o equipo que pueda responder. Si hablamos de supervisión, alguien debe poder detener el proceso, no solo observarlo.
Volvamos a las candidaturas
Antes de utilizar nuestro sistema, dejaría por escrito qué hace y qué no hace. ¿Resume currículums? ¿Puntúa a las personas? ¿Descarta automáticamente? Son actividades distintas, aunque utilicen la misma API.
Después revisaría el origen de los datos, las etiquetas y los resultados por grupos relevantes, sin asumir que una diferencia estadística demuestra por sí sola una discriminación jurídica. La evaluación técnica abre preguntas; no reemplaza todo el análisis.
Diseñaría una revisión que pueda contradecir al modelo, un canal para corregir información y un registro proporcionado de lo que ocurrió. Documentar no significa guardar indefinidamente todos los currículums y conversaciones: la trazabilidad también debe respetar la minimización y los plazos de conservación.
Y acordaría qué sucede si cambia el modelo del proveedor, aparece un patrón de errores o la herramienta empieza a utilizarse para otra finalidad. La aprobación inicial no puede ser la última vez que alguien mire sus consecuencias.
Para mí, ahí se encuentra la parte más práctica de la ética de la IA. No en afirmar que nuestro modelo es responsable, sino en poder mostrar cómo lo comprobamos, qué límites aceptamos y qué hacemos cuando una persona nos dice que el sistema se ha equivocado.
¿Te ha resultado útil? Si te apetece apoyar este espacio, puedes invitarme a un café.
Invítame a un café Apoyo voluntario a través de PayPal. Tú eliges el importe.