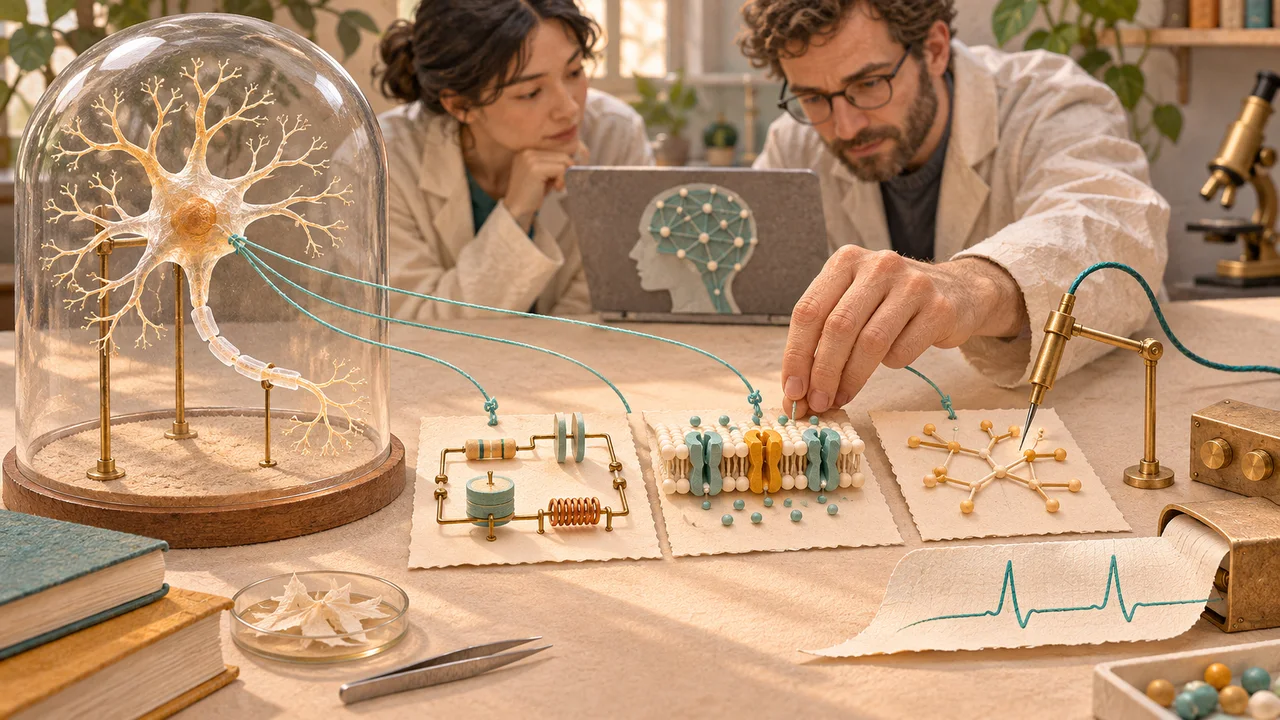
En 1951, Andrew Huxley tuvo que resolver a mano las ecuaciones de una célula nerviosa de calamar. El ordenador que esperaba utilizar había dejado de funcionar y el cálculo, realizado con una máquina mecánica de manivela, le llevó más de tres semanas. Junto con Alan Hodgkin, estaba desarrollando un modelo matemático para explicar cómo las neuronas generan y transmiten impulsos eléctricos.
Del modelo de una neurona al trabajo de una IA
Hodgkin y Huxley querían explicar cómo se produce un impulso eléctrico en una neurona. Para ello, representaron su membrana como un circuito eléctrico y escribieron ecuaciones que describían su funcionamiento. Después calcularon qué actividad predecían esas ecuaciones y la compararon con las mediciones de la célula.
Una parte del modelo describía la apertura de los canales de potasio: pequeños conductos de la membrana por los que pasan iones que contribuyen a la corriente eléctrica. Los investigadores encontraron que, para reproducir las mediciones, una variable de sus ecuaciones debía aparecer elevada a la cuarta potencia, lo que equivale a multiplicar entre sí cuatro copias de esa variable. Otras potencias daban peores resultados.
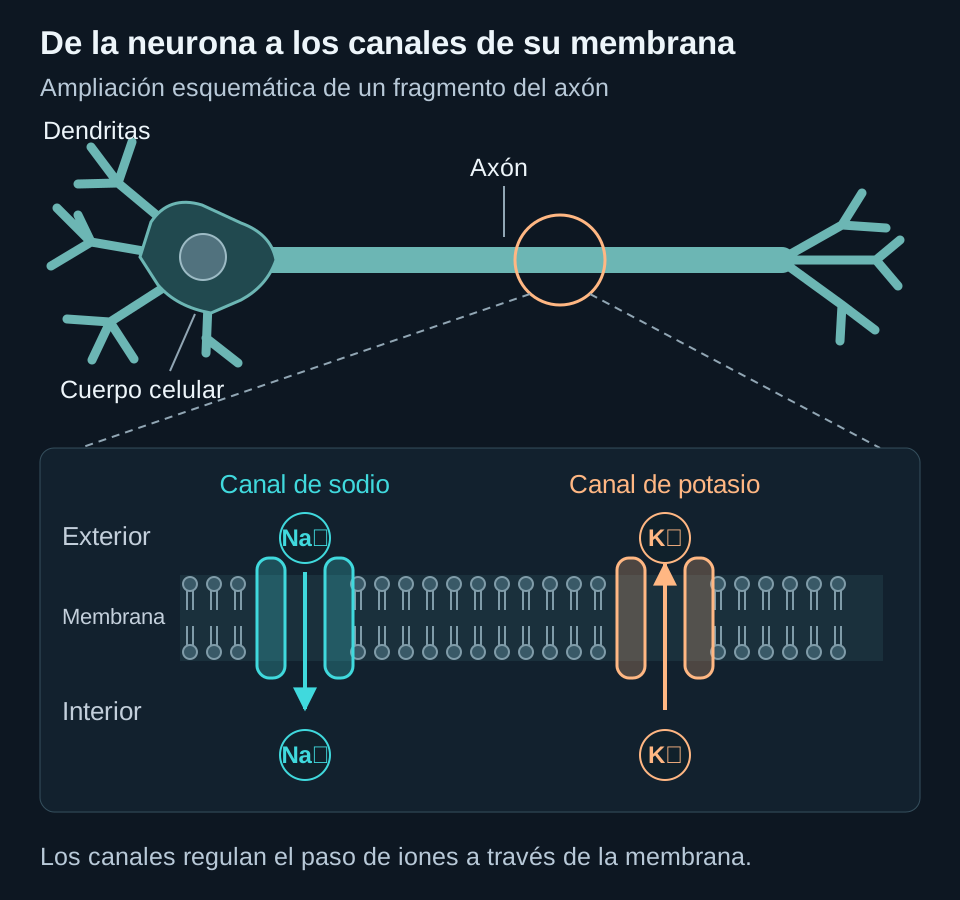
En ese momento conocían el resultado matemático, pero no podían observar la estructura del canal. Intentaron darle una explicación física: quizá su apertura requería que varias partículas se colocaran en una determinada posición. Décadas después, el estudio de un canal de potasio reveló cuatro partes alrededor de un conducto central. Ese hallazgo era compatible con su hipótesis, aunque la ecuación por sí sola no demostraba que el canal tuviera esa estructura.
La conexión con la IA está en ese proceso de proponer ecuaciones y ponerlas a prueba. Un sistema de IA podría recibir las mediciones de la neurona y una descripción del problema, proponer ecuaciones candidatas y utilizar un programa para simular la actividad que predice cada una. Después podría ajustar sus parámetros, comparar las simulaciones con las mediciones y revisar las ecuaciones que no funcionan bien. En este caso, la IA sería la herramienta que ayuda a construir y evaluar el modelo científico de la célula.
Para interpretar una cuarta potencia propuesta por una IA, necesitaríamos saber qué otras relaciones ha probado y cómo se comparan con las mediciones. Esa comparación dio a Hodgkin y Huxley una razón para investigar el significado de su ecuación. Si varias alternativas funcionaran igual de bien, los datos todavía no permitirían elegir una única explicación del canal.
Construir, ajustar e interpretar
El ejemplo de la neurona permite distinguir tres tareas. Primero elegimos unas ecuaciones; después buscamos valores para sus parámetros; por último, estudiamos qué nos permiten afirmar sobre la célula.
| Fase | Qué hacemos | En el modelo de la neurona |
|---|---|---|
| Construir | Elegir las variables y sus relaciones | Decidir cómo representar la apertura de los canales |
| Ajustar e inferir | Buscar valores compatibles con las mediciones | Estimar cuánto contribuye cada tipo de canal a la corriente |
| Interpretar | Investigar qué significan los resultados | Comprobar si una relación matemática refleja un mecanismo del canal |
Llamaremos M a la estructura del modelo: las ecuaciones que hemos elegido. θ representa sus parámetros, es decir, las cantidades cuyo valor tenemos que estimar. D son los datos observados, como las mediciones de la actividad eléctrica de la neurona.
Cambiar el valor de una conductancia —una medida de la facilidad con la que pasa la corriente— modifica un parámetro θ. Sustituir la cuarta potencia por otra relación modifica la estructura M. Esta diferencia será importante al hablar de incertidumbre: podemos desconocer los valores de una ecuación o dudar de la propia ecuación.
Muchos parámetros pueden explicar la misma observación
Imagina una cena de cuatro personas. Conocemos la carta y el precio de cada plato, pero solo conservamos el total de la cuenta: 120 euros. ¿Podemos averiguar qué pidió cada comensal?
Hay varias posibilidades. Las cuatro personas podrían haber elegido un plato de 30 euros cada una. Otra posibilidad es que una persona haya pedido un plato de 60 euros y las otras tres, uno de 20 euros cada una. Ambas combinaciones suman 120 euros. El importe total permite descartar algunos pedidos, pero no reconstruir uno solo.
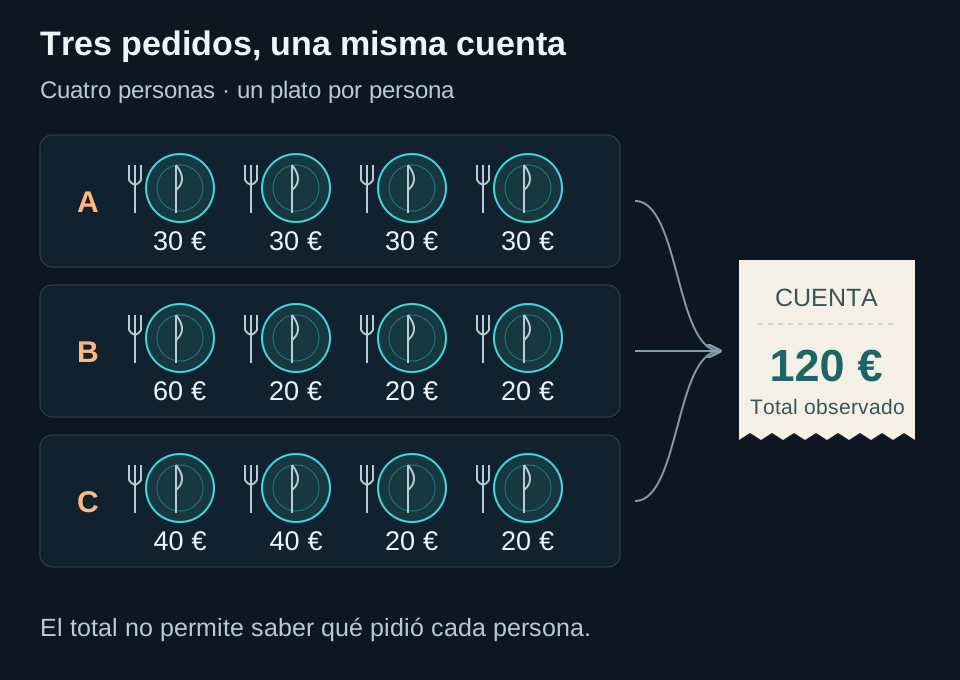
En un modelo neuronal ocurre algo parecido. Lo que medimos es la actividad eléctrica de la célula, del mismo modo que en la cena conocemos el total. Lo que queremos averiguar son los valores de los parámetros que han producido esa actividad, igual que intentamos reconstruir el pedido de cada persona. Distintas combinaciones de parámetros pueden producir una señal casi idéntica, como distintos pedidos pueden sumar la misma cuenta.
La inferencia bayesiana permite valorar esas alternativas combinando lo observado con la información previa. Volvamos a la cena: si sabemos que los comensales suelen elegir platos de precio medio y rara vez piden el más caro, no daríamos necesariamente la misma probabilidad a todos los pedidos que suman 120 euros. El total nos dice cuáles encajan; el conocimiento previo también influye en cuáles consideramos más probables. Esas preferencias son una información adicional al importe de la cuenta.
La regla de Bayes expresa esa actualización. Para una estructura de modelo M fijada:
p(θ | D, M) ∝ p(D | θ, M) · p(θ | M)
Posterior ∝ verosimilitud × previa
En el ejemplo, D es la cuenta de 120 euros; θ representa lo que pidió cada persona; y M reúne las reglas que hemos fijado: cuatro comensales, un plato por persona y los precios de la carta.
- Previa, p(θ | M): qué probabilidad asignamos a cada pedido antes de conocer el total, a partir de lo que sabemos de los comensales.
- Verosimilitud, p(D | θ, M): qué probabilidad tendría una cuenta de 120 euros si ese fuera el pedido. En este ejemplo sin errores ni gastos adicionales, un pedido que suma 80 euros queda descartado y uno que suma 120 es compatible.
- Posterior, p(θ | D, M): cómo quedan las probabilidades de los pedidos después de incorporar la cuenta observada. Puede seguir habiendo varias alternativas.
El símbolo ∝ significa «es proporcional a»: multiplicamos la verosimilitud por la previa y después normalizamos el resultado para obtener una distribución de probabilidad. La barra | se lee «dado»: p(θ | D, M) se refiere a los parámetros una vez conocidos los datos y fijado el modelo.
La diferencia entre verosimilitud y posterior se ve al cambiar la pregunta. «Si pidieron estos platos, ¿qué cuenta esperaríamos?» va del pedido al total. «Sabiendo el total, ¿qué podrían haber pedido?» recorre el camino inverso. En un modelo científico, Bayes ayuda a pasar de las mediciones a una distribución de parámetros posibles, sin dar por hecho que existe una única respuesta.
En un modelo neuronal, aumentar un parámetro y reducir otro puede dejar la señal casi igual. La posterior representa esa incertidumbre. Para calcularla suelen utilizarse aproximaciones, como métodos que toman muestras de la distribución sin recorrer todos los valores posibles.
Inferencia basada en simulaciones: aprender el camino inverso
En la cena, pasar del pedido al total es sencillo: basta con sumar los precios. Con la neurona también podemos introducir unos parámetros en un programa y calcular la señal eléctrica que producirían. Ese programa es un simulador del modelo científico.
La dificultad aparece al calcular la verosimilitud. Un simulador complejo puede generar señales con variaciones aleatorias sin ofrecer una manera práctica de evaluar la probabilidad de las mediciones reales. Generar una señal posible y calcular la probabilidad de una observación son operaciones diferentes.
La inferencia basada en simulaciones, o SBI (simulation-based inference), permite abordar esos casos. Uno de sus enfoques, la estimación neuronal de la posterior, utiliza una red entrenada con ejemplos del simulador.
Cómo se entrena y utiliza la red
- Elegimos muchas combinaciones de parámetros. En la neurona, podrían ser distintos valores de las conductancias de sodio y potasio, dentro de los rangos que queremos estudiar.
- Simulamos la actividad de cada combinación. Guardamos los parámetros y la señal eléctrica que produce cada simulación.
- Entrenamos una red con esas parejas. Aprende a asociar las señales con una distribución de parámetros que podrían haberlas generado.
- Le damos una medición real. La red devuelve una aproximación a la distribución de parámetros compatibles con esa observación, bajo el modelo y la previa utilizados.
El simulador genera señales a partir de parámetros; la red ayuda a inferir parámetros a partir de señales. La red aprende de los ejemplos del simulador, que es nuestra representación de la célula.
qφ(θ | D) ≈ p(θ | D, M)
La red aproxima la posterior
Mantenemos D para los datos: señales simuladas durante el entrenamiento o mediciones reales al utilizar la red. θ son los parámetros científicos y φ, los pesos de la red. El símbolo ≈ indica una aproximación; el modelo M se mantiene fijo.
Generar las simulaciones y entrenar la red puede ser costoso. Después podemos reutilizarla para analizar nuevas mediciones del dominio aprendido. Es la inferencia amortizada: gran parte del coste se concentra al principio. Una señal muy distinta de las simuladas puede exigir más ejemplos o revisar el modelo.
Cómo se comprueban los resultados
Podemos utilizar señales simuladas cuyos parámetros conocemos y evaluar si la incertidumbre que devuelve la red es adecuada. Esto ayuda a comprobar su calibración.
También podemos tomar parámetros de la posterior, generar nuevas señales y compararlas con las mediciones reales. Estas comprobaciones predictivas posteriores permiten detectar si el modelo reproduce características importantes de la actividad observada.
SBI incluye otros enfoques que aproximan la verosimilitud o comparan probabilidades de los datos bajo distintos parámetros; no todos utilizan redes neuronales.
La incertidumbre también está en las ecuaciones
Hasta ahora hemos mantenido las ecuaciones de la neurona y hemos buscado valores para sus parámetros. Pero también podríamos preguntarnos si la apertura de un canal debe representarse con una cuarta potencia o con otra relación. En ese caso, estamos comparando modelos científicos diferentes.
Conviene distinguir los dos niveles:
- Incertidumbre paramétrica: hemos elegido unas ecuaciones, pero varias combinaciones de valores reproducen las mediciones.
- Incertidumbre estructural: distintas ecuaciones reproducen las mediciones y no sabemos cuál representa mejor el sistema.
La IA puede ayudar a explorar el segundo nivel. Un agente basado en un modelo de lenguaje puede escribir el código de varios simuladores, ejecutarlos y comparar sus resultados con los datos. Para valorar cada propuesta necesita también ajustar o inferir sus parámetros. Si una propuesta falla, puede modificar sus ecuaciones y volver a probarla.
Si dos estructuras explican las mismas mediciones, necesitamos una forma de valorar su respaldo. Elegir únicamente la que mejor ajusta puede ocultar otras explicaciones plausibles.
La comparación también puede expresarse mediante Bayes:
p(M | D) ∝ p(D | M) · p(M)
Posterior del modelo ∝ evidencia × previa
Ahora actualizamos la probabilidad de M, la estructura del modelo. p(M) recoge los supuestos previos sobre las estructuras que consideramos. p(D | M) es la evidencia: resume cómo explica los datos un modelo al considerar sus parámetros según la previa, en lugar de valorar únicamente su mejor ajuste.
Por ejemplo, una ecuación podría reproducir las mediciones solo al ajustar sus parámetros de una manera muy precisa, mientras otra lo hace para un conjunto más amplio de valores plausibles. La evidencia tiene en cuenta esa diferencia. El resultado depende de las previas elegidas; no basta con contar parámetros para decidir qué modelo recibe más respaldo.
Una colección de ecuaciones generadas por un agente no es, por sí sola, una distribución bayesiana. Que el agente proponga una ecuación muchas veces no demuestra que sea más probable científicamente: hay que definir cómo se evalúa y se asigna peso a cada alternativa.
Varios modelos también pueden coincidir porque comparten el mismo error. Si todos omiten un mecanismo importante de la célula, podrían hacer la misma predicción equivocada. El acuerdo debe valorarse teniendo en cuenta los supuestos compartidos.
Un experimento que separe dos explicaciones
Para ver cómo el desacuerdo entre modelos orienta una medición, usemos un ejemplo hipotético: aplicamos un estímulo de intensidad x y medimos una respuesta y. Solo hemos probado estímulos débiles y, en ese rango, la respuesta parece crecer en línea recta.
Hay al menos dos explicaciones posibles:
- Modelo lineal: y = ax + b + ε. Cada aumento de x produce el mismo incremento de la respuesta. El parámetro a indica cuánto crece y; b, su valor cuando x es cero.
- Modelo con saturación: y = c(1 − e−kx) + ε, con c y k positivos. La respuesta crece al principio, pero se aproxima a un límite c. El parámetro k regula la rapidez con la que se acerca a ese límite.
En ambas ecuaciones, ε representa las variaciones que tratamos como ruido. Cuando x es pequeño, el inicio de la curva de saturación se parece a una recta. Matemáticamente, si kx es pequeño, 1 − e−kx ≈ kx. Por eso los dos modelos pueden dar resultados muy parecidos para los estímulos débiles que hemos medido.
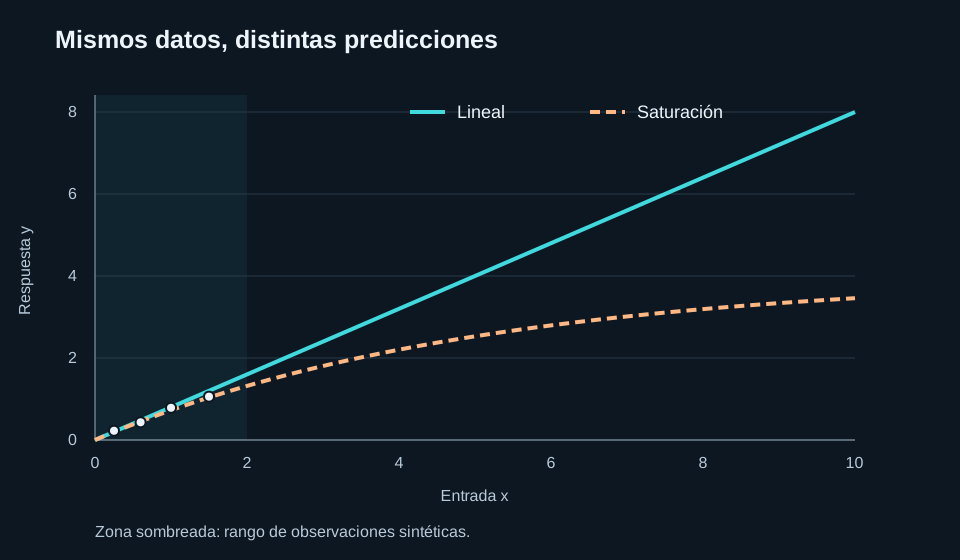
Tomar muchas más mediciones con esos mismos estímulos puede mejorar la precisión sin revelar si la respuesta termina saturándose. Una medición con un estímulo mayor, dentro de condiciones experimentales válidas, pondría a prueba una diferencia concreta: el modelo lineal predice que la respuesta seguirá creciendo al mismo ritmo; el otro predice que el crecimiento se frenará.
Una IA podría señalar ese rango como un lugar útil para medir. Los investigadores decidirían cómo realizar el experimento y compararían su resultado con las dos predicciones.
Distinguir modelos y distinguir parámetros
En el ejemplo anterior comparamos dos estructuras. Dentro de una misma estructura también puede haber valores difíciles de distinguir. Cerca del origen, el modelo de saturación se comporta aproximadamente como y = ckx: las observaciones informan sobre el producto ck, pero pueden dejar mucha incertidumbre sobre c y k por separado.
La identificabilidad estudia si podemos distinguir los parámetros de un modelo a partir de las observaciones. La identificabilidad estructural plantea esa pregunta en condiciones ideales; la práctica considera las limitaciones de los datos reales, como el ruido y el número de mediciones. Si dos parámetros producen exactamente el mismo efecto observable, repetir la misma medición con mayor precisión no bastará para separarlos.
Interpretar un modelo exige ponerlo a prueba
Además de cambiar la intensidad del estímulo, podemos intervenir sobre un mecanismo de la célula: por ejemplo, bloquear una parte de sus canales de sodio.
Primero simulamos el bloqueo. Dos modelos que reproducían la actividad inicial podrían predecir cambios diferentes. Ese desacuerdo indica qué efecto convendría medir en la célula. Después realizamos el experimento y comprobamos qué modelos siguen siendo compatibles con las observaciones.
Así empezamos a evaluar la explicación biológica que atribuimos a las ecuaciones. Si un modelo acierta al predecir el efecto de bloquear un canal, gana respaldo para representar ese mecanismo. Una sola intervención no confirma todos sus detalles, pero aporta una prueba distinta del ajuste a la actividad inicial.
De una neurona a sistemas completos
Para modelar un cerebro necesitamos representar también cómo se conectan las neuronas y cómo influye la actividad de unas sobre otras. Un conectoma es un mapa de esas conexiones, pero saber que dos neuronas están conectadas no nos dice cuánto influye una sobre la otra. Todavía debemos representar las células, asignar valores a sus conexiones y comparar la actividad simulada con mediciones.
La IA puede ayudar a construir y evaluar muchos modelos de ese sistema. Para estudiar una conexión, podríamos simular su eliminación en cada uno y observar qué cambios de comportamiento predicen. Si las respuestas varían mucho, la función que atribuimos a esa conexión dependería de supuestos aún por resolver.
Esta forma de comparar alternativas también se utiliza en otros campos: en las simulaciones climáticas se estudia cómo cambian las proyecciones con los supuestos, y en física de partículas las mediciones descartan versiones de una teoría mientras dejan abiertas otras.
Qué deberíamos pedir a una IA científica
Una IA puede proponer ecuaciones y encontrar parámetros que reproduzcan las mediciones. Para que ese resultado ayude a la ciencia, también debe mostrar qué otras explicaciones podrían encajar y qué observación permitiría distinguirlas.
En el caso de la neurona, eso significa explicar qué ecuaciones probó, qué predice cada una y cómo cambiaría la señal si se modifica un canal. Así, el investigador puede elegir qué medir y usar el resultado para revisar las explicaciones.
El valor de la IA científica no está solo en encontrar una respuesta, sino en ayudar a descubrir qué experimento puede ponerla a prueba.
Fuente
Artículo de elaboración propia a partir del documento de estudio «Enseñar a la IA a construir modelos científicos»: Teaching AI to build scientific models, de Jakob Macke, Daniel Gedon y Stefan Wahl, en Anthropic Research.
¿Te ha resultado útil? Si te apetece apoyar este espacio, puedes invitarme a un café.
Invítame a un café Apoyo voluntario a través de PayPal. Tú eliges el importe.